
検索ボット
検索ボットとは?
検索ボット(スパイダーと呼ばれることもあります)は、インターネットを継続的にブラウズするロボットで、通常は検索インデックスを構築するために使用されます。
ボットはトラフィック数を人為的に増加させる可能性があるため、それらの存在を認識することが重要です。
検索ボットとLinkly
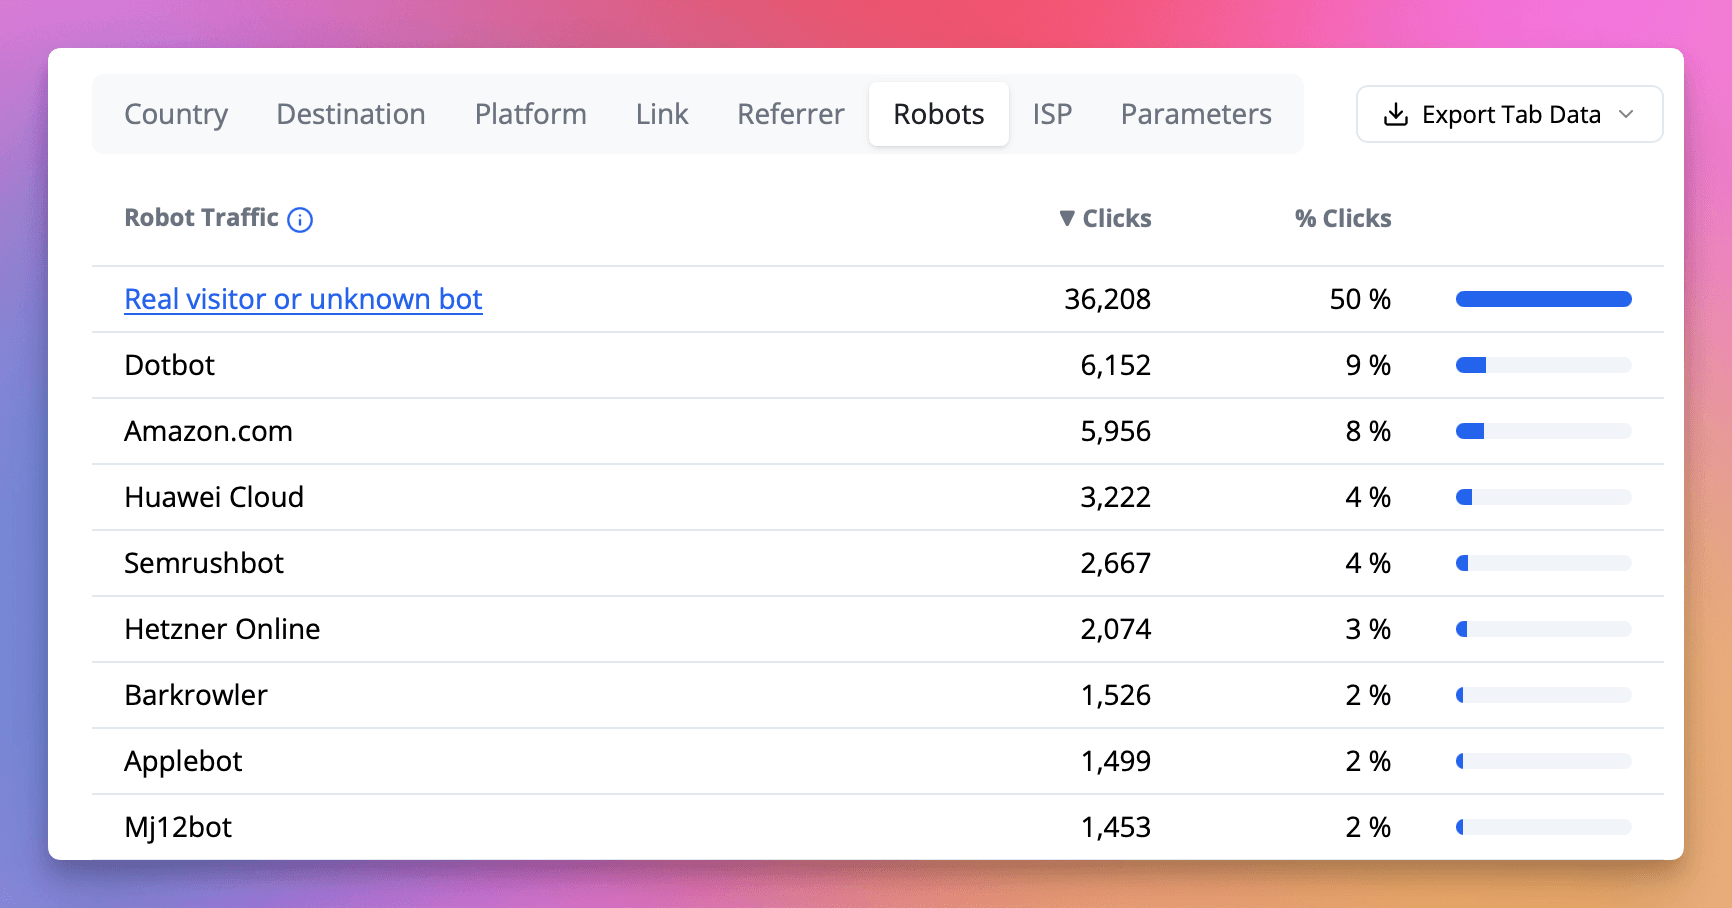
Linklyは、意図的に自分自身を明かす検索ボットとスパイダーを検出できます。トラフィックレポートのボットセクションで、どのクリックがボットに帰属されているかを確認できます。
ボットトラフィックとボットをブロックする方法に関する記事があります(ボットトラフィックとボットのブロック方法)。
ソーシャルメディアクローラーの特別な処理
Linklyは、Facebook、YouTube、Google、LinkedIn、Xからのソーシャルメディアクローラーの処理を改善しました。
これらのクローラーからのトラフィックがあなたのリンクにヒットした場合:
- アナリティクスに記録されません
- クリック数の制限にカウントされません
- クローラーは透過的にリダイレクトされて正しい宛先に到達します
- 「ロボットをブロック」機能が有効になっている場合でも、これらのクローラーは常に許可されます
これにより、ソーシャルメディアクローラーがクリック数の制限を消費するのを防ぎながら、プレビューを生成してリンクをチェックできるようにします。
リンクをたどるボットをブロックする
Linklyはロボットと検索スパイダーがリンクをたどるのをブロックできます。ボットブロッキングを有効にする手順については、ボットトラフィックを参照してください。
重要: Facebook、YouTube、Google、LinkedIn、X、WhatsApp、Telegramからのソーシャルメディアクローラーは、ブロッキングが有効な場合でも常に許可されるため、リンクプレビューは機能し続けます。例外は、クラウドホスティングネットワークからこれらのプラットフォームになりすまし要求であり、それでもブロックされます。
ボットはクリック制限にカウントされますか?
Facebook、YouTube、Google、LinkedIn、Xからのソーシャルメディアクローラーは、クリック制限にカウントされず、アナリティクスに記録されません。
以下に示されている他のすべてのボットは、クリック数の制限にカウントされます。ソースに関係なく、トラフィックの監視とリダイレクトに同じコストがかかるためです。
ブロックされたボット(ブロックページに遭遇するボット)も制限にはカウントされません。
検索ボットのリスト
以下は、Linklyが識別し、必要に応じてブロック可能な検索ボットとそのユーザーエージェントのリストです。
- 200pleasebot 200PleaseBot
- 360spider 360Spider
- abot CrawlDaddy、abot
- addthis AddThis
- adldxbot Microsoft Bing Ads
- admantx ADmantX Platform Semantic Analyzer
- adsbot-google Google Adwords
- advbot AdvBot
- ahrefsbot Ahrefs バックリンク調査ツール
- alexa Alexa Crawler
- apache-httpclient Java http ライブラリ
- apachebench ApacheBench (ab)
- apis-google APIs-Google
- appengine-google Google App Engine
- applebot Apple Bot
- archive.org_bot Internet Archive (archive.org)
- ask jeeves Ask Jeeves
- asynchttpclient Java http および WebSocket クライアントライブラリ
- awe.sm Awe.sm URL エキスパンダー
- baidu Baidu
- bdcbot Big Data Corp
- bingbot Microsoft Bing
- bingpreview Microsoft Bing プレビュー
- bitlybot bit.ly bot
- blekkobot Blekkobot
- blexbot BLEXBot (webmeup)
- bot@linkfluence.net Linkfluence bot
- bufferbot BufferBot
- buibui-checkbot buibui
- butterfly Topsy Labs
- buzztalk buzztalk
- catchbot CatchBot (catchbot.com)
- check_http Nagios モニター
- cliqzbot Cliqzbot
- cmradar/0.1 CMRadar/0.1
- coldfusion ColdFusion http ライブラリ
- commoncrawl CCBot
- comodo-webinspector-crawler Comodo
- crowsnest Crowsnest
- curabot cura.yt
- curl curl unix CLI http クライアント
- dap/nethttp DAP/NetHTTP
- datagnionbot datagnion.com/bot.html
- daumoa 韓国ポータルおよび検索エンジンインデックスボット
- developers.google.com/+/web/snippet/ Google Plus
- diffbot Diffbot
- digitalpersona 指紋認証ソフトウェア HP 指紋スキャナー
- domain re-animator bot Domain Re-Animator Bot
- domainsbot DomainsBot
- domaintunocrawler DomainTuno
- dotbot Dot Bot
- duckduck Duck Duck Go
- elb-healthchecker AWS ELB HealthChecker
- embedly Embedly
- eoaagent EOAAgent
- eventmachine httpclient Ruby http ライブラリ
- everyonesocialbot EveryoneSocial
- evrinid Evri bot
- exabot Exalead のボット
- exaleadcloudview ExaleadCloudView
- facebookexternalhit Facebook Bot
- facebot Facebook Bot
- feedburner RSS bot
- feedfetcher-google Google Feedfetcher
- findxbot Findxbot
- flipboardproxy FlipboardProxy
- friendfeedbot FriendFeed
- genieo Genieo Web フィルターボット
- getprismatic.com getprismatic.com
- gigabot Gigabot spider
- gimme60bot Gimme60 (gimme60.com)
- gimmeusabot Gimme60 (gimme60.com)
- go http package Go http ライブラリ
- google page speed insights Google Page Speed Insights
- google Web Preview Google Instant Previews クローラー
- google-structured-data-testing-tool Google-StructuredDataTestingTool
- google-structureddatatestingtool Google-StructuredDataTestingTool
- googlebot Google Bot
- googlestackdrivermonitoring-uptimechecks GoogleStackdriverMonitoring-UptimeChecks
- grapeshotcrawler GrapeshotCrawler
- gravitybot Gravity Bot
- hatena::bookmark Hatena::Bookmark
- heritrix heritrix
- htmlparser HTMLParser
- http_request2 HTTP_Request2
- httpclient HTTPClient
- https://developers.google.com/+/web/snippet Google+ スニペットフェッチャー
- hubspot HubSpot
- ia_archiver Internet Archive (WayBackMachine)
- icoreservice iCoreService
- idmarch idmarch.org/bot.html
- inagist URL リゾルバー
- insieve Insieve Bot
- insitesbot Insitesbot
- instapaper Instapaper
- istellabot IstellaBot
- jack jack
- jakarta commons Jakarta Commons HttpClient
- java 汎用 Java http ライブラリ
- jetslide Jetslide
- js-kit URL リゾルバー
- kemvibot Kemvi
- kimengi Kimengi Bot
- knows.is knows.is
- kojitsubot Kojitsubot
- komodiabot KomodiaBot
- kraken kraken
- laconica Laconica
- libwww-perl Perl クライアントサーバーライブラリ
- lijit crawler Lijit
- linkdexbot Linkdex Bot
- linkedinbot LinkedIn
- linkscrawler LinksCrawler
- linode Linode Longview
- lipperhey Lipperhey
- livelapbot Livelapbot
- loadtimebot Load Time Bot
- longurl URL エキスパンダーサービス
- ltx71 ltx71.com
- lumibot Lumibot
- lwp-trivial 別の Perl ライブラリ
- magpie-crawler magpie-crawler
- mail.ru_bot Mail.ru Bot
- meanpathbot meanpath
- mediapartners-google Google Adsense bot
- megaindex.ru MegaIndex
- memorybot mignify.com/bot.html
- metauri MetaURI
- mfe_expand Mcafee spider
- mir web crawler MIR web crawler
- mj12bot Majestic-12 spider
- mojeekbot Mojeek UK 検索クローラー
- mrchrome MrChrome
- ms search 6.0 robot MS Search 6.0 Robot
- msnbot-media Microsoft メディアボット
- msnbot Microsoft bot
- nerdybot NerdyBot
- netcraft Netcraft
- netstate netEstate NE Crawler
- netvibes パーソナライズダッシュボードボット
- netzcheckbot netzcheck
- newrelicmonitor NewRelic モニター
- newrelicpinger NewRelicPinger
- newsme newsme
- niki-bot niki-bot
- ning NING - Yet Another Twitter Swarmer
- nutch Apache 検索スパイダー
- openhosebot OpenHoseBot
- orangebot OrangeBot
- pagesinventory pagesinventory.com
- panopta 監視サービス
- paperlibot PaperLi
- peerindex peerindex
- percolatecrawler PercolateCrawler
- perfectmarketkwtbot PerfectMarket
- phantomjs PhantomJS
- pingdom Pingdom 監視
- pinterest Pinterest
- plukkie botje.com/plukkie.htm
- privacyawarebot PrivacyAwareBot
- proximic Proximic Spider
- psbot-page Picsearch
- publiclibraryarchive.org publiclibraryarchive.org
- pycurl Python http ライブラリ
- python-httplib2 Python-httplib2
- python-requests Python http ライブラリ
- python-urllib Python http ライブラリ
- queryseeker QuerySeekerSpider
- quicklook QuickLook
- re-animator Domain Re-Animator Bot
- readability Readability
- rebelmouse RebelMouse
- redditbot Reddit Bot
- relateiq RelateIQ
- riddler Riddler Bot
- rogerbot SeoMoz spider
- rssmicro RSS/Atom フィードロボット (rssmicro.com)
- ruby Ruby
- scrapy Scrapy
- screaming frog seo spider Screaming Frog SEO Spider
- searchmetricsbot SearchmetricsBot
- semrushbot SEO 分析ボット
- seokicks SEOKicks
- seznambot SeznamBot
- shopwiki ShopWiki
- shortlinktranslate リンク短縮ツール
- showyoubot Showyou iOS アプリスパイダー
- siege Joe Dog Siege
- sistrix SISTRIX
- siteuptime サイト監視サービス
- slack Slackbot-LinkExpanding
- slackbot Slack Bot
- slurp Yahoo spider
- smtbot SimilarTech
- socialrank SocialRankIOBot
- sogou 中国検索エンジン
- spbot OpenLinkProfiler
- spider 汎用ウェブスパイダー
- spinn3r Spinn3r aggregator
- sputnikbot SputnikBot
- squider Squider
- statuscake StatusCake
- stripe Stripe
- test certificate info C http ライブラリ?
- tineye TinEye Bot
- traackr Traackr Bot
- trendictionbot Trendiction Search
- turnitinbot TurnitinBot
- tweetedtimes The Tweeted Times
- tweetmemebot TweetMeMe Crawler
- twikle ソーシャルウェブ検索ボット
- twitjobsearch TwitJobSearch
- twitmunin Twitmunin
- twitterbot Twitter URL エキスパンダー
- twurly Twurly
- typhoeus Typhoeus
- umbot uberMetrics
- unwindfetch Gnip
- uptimerobot Uptime Robot
- vagabondo Vagabondo
- vb project Visual Basic
- vigil Vigil
- vkshare VKontake Sharer
- voilabot VoilaBot
- vrcrawler Venture Radar
- wasalive-bot Wasalive Bots
- watchsumo WatchSumo
- wbsearchbot Ware Bay Best Buys
- webscout Webscout
- wesee WeSEE
- wget wget unix CLI http クライアント
- wordpress WordPress spider
- wormly WormlyBot
- wotbox Wotbox
- xenu link sleuth Xenu Link Sleuth
- xing-contenttabreceiver Xing bot
- xovibot XoviBot
- yacybot YaCy
- yahoo-ad-monitoring Yahoo 広告監視
- yandex Yandex
- yeti Naver Corp
- yourls YOURLS
- zelist.ro フィードパーサー
- zibb ZIBB spider
- zitebot Zite
- zyborg Zyborg
ボットとして識別されるクラウドプロバイダー
多くのボットは自分自身をそのように識別しませんが、私たちはインターネットサービスプロバイダーを追跡し、主要なクラウドプロバイダーからのトラフィックをボットの可能性があるものとして識別します。
- Google Cloud
- Microsoft Corporation
- OVH SAS
- DigitalOcean
- Huawei Clouds
- Google-private-cloud
- Amazon.com
- Google Proxy
- Omonia d.o.o.
- ColoCrossing
検索ボット よくある質問
Linkly はどのようにボットを検出しますか?
Linklyはユーザーエージェント文字列を通じてボットを識別します(多くのボットは自分自身を公表します)。また、トラフィックが既知のクラウドホスティングプロバイダーやデータセンターから発信されているかどうかをチェックします。
なぜ実際のユーザーからのクリックがボットとしてマークされることがあるのですか?
VPN または企業ネットワーク上のユーザーは、トラフィックがデータセンターを経由するため、ボットとしてフラグが立てられる可能性があります。詳細については、VPN トラフィックに関する記事を参照してください。
毎月500クリックを無料で追跡できます。