
Robots de recherche
Qu'est-ce qu'un robot de recherche ?
Un robot de recherche, parfois appelé spider, est un robot qui parcourt continuellement internet, généralement dans le but de construire un index de recherche.
Les robots peuvent gonfler artificiellement les chiffres de trafic, il est donc important d'être conscient de leur existence.
Robots de recherche et Linkly
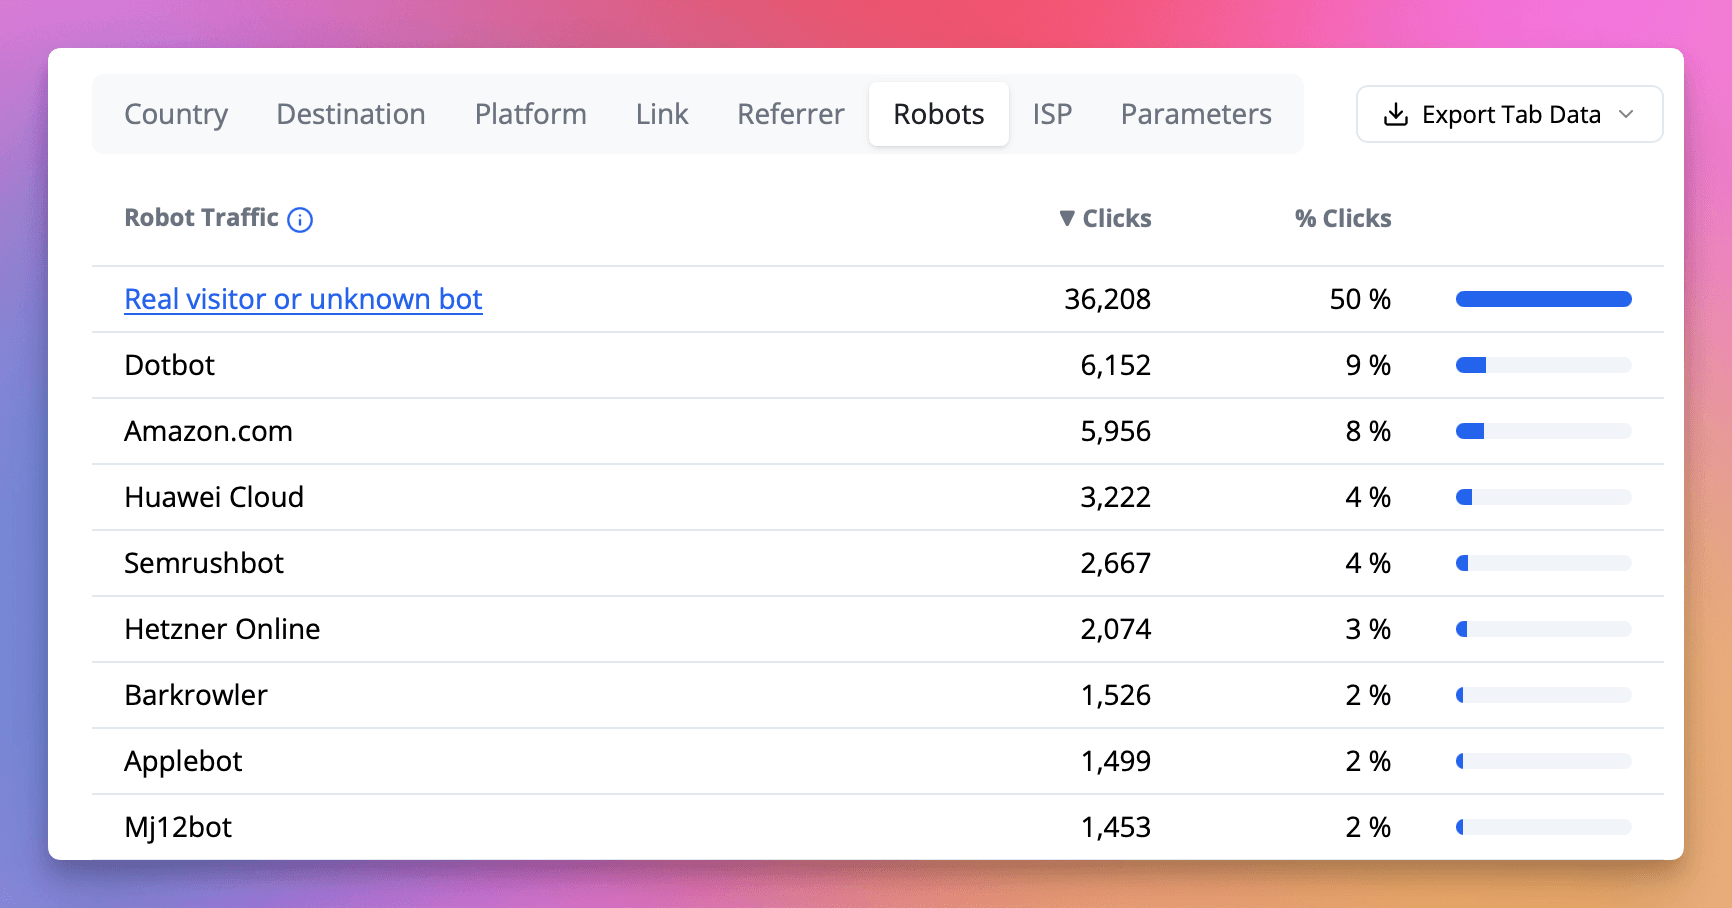
Linkly peut détecter les robots et spiders de recherche qui se révèlent délibérément. Vous pouvez voir quels clics ont été attribués aux robots dans la section Bots du rapport de trafic.
Nous avons un article sur le trafic des robots et comment bloquer les robots.
Traitement spécial pour les crawlers de réseaux sociaux
Linkly a amélioré la gestion des crawlers de réseaux sociaux provenant de Facebook, YouTube, Google, LinkedIn et X.
Lorsque le trafic de ces crawlers accède à vos liens :
-
Il n'est pas enregistré dans votre analyse
-
Il ne compte pas par rapport à vos limites de clics
-
Le crawler est redirigé de manière transparente vers la destination correcte
-
Ces crawlers sont toujours autorisés, même lorsque la fonction « bloquer les robots » est activée
Cela empêche les crawlers de réseaux sociaux de consommer vos limites de clics tout en leur permettant de générer des aperçus et de vérifier vos liens.
Bloquer les robots de suivre les liens
Linkly peut bloquer les robots et les spiders de recherche de suivre vos liens. Consultez Trafic des robots pour les instructions sur l'activation du blocage des robots.
Important : Les crawlers de réseaux sociaux de Facebook, YouTube, Google, LinkedIn, X, WhatsApp et Telegram sont toujours autorisés même lorsque le blocage est activé, afin que les aperçus de liens continuent à fonctionner. L'exception concerne les demandes usurpant l'identité de ces plateformes en provenance de réseaux d'hébergement cloud, qui sont toujours bloquées.
Les robots comptent-ils par rapport aux limites de clics ?
Les crawlers de réseaux sociaux de Facebook, YouTube, Google, LinkedIn et X ne comptent pas par rapport à vos limites de clics et ne sont pas enregistrés dans votre analyse.
Tous les autres robots identifiés ci-dessous comptent par rapport à vos limites de clics, car le coût de surveillance et de redirection du trafic est le même quelle que soit la source.
Les robots bloqués (ceux qui rencontrent une page de blocage) ne comptent pas non plus par rapport à vos limites.
Liste des robots de recherche
Ci-dessous se trouve une liste des robots de recherche et de leurs user-agents que Linkly identifie et qui peuvent être bloqués si nécessaire.
- 200pleasebot 200PleaseBot
- 360spider 360Spider
- abot CrawlDaddy, abot
- addthis AddThis
- adldxbot Microsoft Bing Ads
- admantx ADmantX Platform Semantic Analyzer
- adsbot-google Google Adwords
- advbot AdvBot
- ahrefsbot Outil de recherche de backlinks Ahrefs
- alexa Alexa Crawler
- apache-httpclient Bibliothèque http Java
- apachebench ApacheBench (ab)
- apis-google APIs-Google
- appengine-google Google App Engine
- applebot Apple Bot
- archive.org_bot Internet Archive (archive.org)
- ask jeeves Ask Jeeves
- asynchttpclient Bibliothèque client http et WebSocket Java
- awe.sm Awe.sm URL expander
- baidu Baidu
- bdcbot Big Data Corp
- bingbot Microsoft Bing
- bingpreview Microsoft Bing preview
- bitlybot bit.ly bot
- blekkobot Blekkobot
- blexbot BLEXBot (webmeup)
- bot@linkfluence.net Bot Linkfluence
- bufferbot BufferBot
- buibui-checkbot buibui
- butterfly Topsy Labs
- buzztalk buzztalk
- catchbot CatchBot (catchbot.com)
- check_http Nagios monitor
- cliqzbot Cliqzbot
- cmradar/0.1 CMRadar/0.1
- coldfusion Bibliothèque http ColdFusion
- commoncrawl CCBot
- comodo-webinspector-crawler Comodo
- crowsnest Crowsnest
- curabot cura.yt
- curl curl CLI unix client http
- dap/nethttp DAP/NetHTTP
- datagnionbot datagnion.com/bot.html
- daumoa Bot d'indexation du portail et moteur de recherche coréen
- developers.google.com/+/web/snippet/ Google Plus
- diffbot Diffbot
- digitalpersona Logiciel d'empreinte digitale scanner d'empreinte HP
- domain re-animator bot Domain Re-Animator Bot
- domainsbot DomainsBot
- domaintunocrawler DomainTuno
- dotbot Dot Bot
- duckduck Duck Duck Go
- elb-healthchecker AWS ELB HealthChecker
- embedly Embedly
- eoaagent EOAAgent
- eventmachine httpclient Bibliothèque http Ruby
- everyonesocialbot EveryoneSocial
- evrinid Bot Evri
- exabot Bot d'Exalead
- exaleadcloudview ExaleadCloudView
- facebookexternalhit Bot Facebook
- facebot Bot Facebook
- feedburner Bot RSS
- feedfetcher-google Google Feedfetcher
- findxbot Findxbot
- flipboardproxy FlipboardProxy
- friendfeedbot FriendFeed
- genieo Bot filtre web Genieo
- getprismatic.com getprismatic.com
- gigabot Spider Gigabot
- gimme60bot Gimme60 (gimme60.com)
- gimmeusabot Gimme60 (gimme60.com)
- go http package Bibliothèque http Go
- google page speed insights Google Page Speed Insights
- google Web Preview Crawler Google Instant Previews
- google-structured-data-testing-tool Google-StructuredDataTestingTool
- google-structureddatatestingtool Google-StructuredDataTestingTool
- googlebot Bot Google
- googlestackdrivermonitoring-uptimechecks GoogleStackdriverMonitoring-UptimeChecks
- grapeshotcrawler GrapeshotCrawler
- gravitybot Gravity Bot
- hatena::bookmark Hatena::Bookmark
- heritrix heritrix
- htmlparser HTMLParser
- http_request2 HTTP_Request2
- httpclient HTTPClient
- https://developers.google.com/+/web/snippet Collecteur d'extraits Google+
- hubspot HubSpot
- ia_archiver Internet Archive (WayBackMachine)
- icoreservice iCoreService
- idmarch idmarch.org/bot.html
- inagist Résolveur d'URL
- insieve Bot Insieve
- insitesbot Insitesbot
- instapaper Instapaper
- istellabot IstellaBot
- jack jack
- jakarta commons Jakarta Commons HttpClient
- java Bibliothèque http Java générique
- jetslide Jetslide
- js-kit Résolveur d'URL
- kemvibot Kemvi
- kimengi Bot Kimengi
- knows.is knows.is
- kojitsubot Kojitsubot
- komodiabot KomodiaBot
- kraken kraken
- laconica Laconica
- libwww-perl Bibliothèque client-serveur Perl
- lijit crawler Lijit
- linkdexbot Bot Linkdex
- linkedinbot LinkedIn
- linkscrawler LinksCrawler
- linode Linode Longview
- lipperhey Lipperhey
- livelapbot Livelapbot
- loadtimebot Load Time Bot
- longurl Service d'expansion d'URL
- ltx71 ltx71.com
- lumibot Lumibot
- lwp-trivial Autre bibliothèque Perl
- magpie-crawler magpie-crawler
- mail.ru_bot Mail.ru Bot
- meanpathbot meanpath
- mediapartners-google Bot Google Adsense
- megaindex.ru MegaIndex
- memorybot mignify.com/bot.html
- metauri MetaURI
- mfe_expand Spider Mcafee
- mir web crawler Crawler web MIR
- mj12bot Spider Majestic-12
- mojeekbot Crawler de recherche Mojeek UK
- mrchrome MrChrome
- ms search 6.0 robot Bot MS Search 6.0
- msnbot-media Bot média Microsoft
- msnbot Bot Microsoft
- nerdybot NerdyBot
- netcraft Netcraft
- netstate Crawler NE netEstate
- netvibes Bot tableau de bord personnalisé
- netzcheckbot netzcheck
- newrelicmonitor Moniteur NewRelic
- newrelicpinger NewRelicPinger
- newsme newsme
- niki-bot niki-bot
- ning NING - Yet Another Twitter Swarmer
- nutch Spider de recherche Apache
- openhosebot OpenHoseBot
- orangebot OrangeBot
- pagesinventory pagesinventory.com
- panopta Service de surveillance
- paperlibot PaperLi
- peerindex peerindex
- percolatecrawler PercolateCrawler
- perfectmarketkwtbot PerfectMarket
- phantomjs PhantomJS
- pingdom Surveillance Pingdom
- pinterest Pinterest
- plukkie botje.com/plukkie.htm
- privacyawarebot PrivacyAwareBot
- proximic Spider Proximic
- psbot-page Picsearch
- publiclibraryarchive.org publiclibraryarchive.org
- pycurl Bibliothèque http Python
- python-httplib2 Python-httplib2
- python-requests Bibliothèque http Python
- python-urllib Bibliothèque http Python
- queryseeker QuerySeekerSpider
- quicklook QuickLook
- re-animator Domain Re-Animator Bot
- readability Readability
- rebelmouse RebelMouse
- redditbot Bot Reddit
- relateiq RelateIQ
- riddler Bot Riddler
- rogerbot Spider SeoMoz
- rssmicro Robot flux RSS/Atom (rssmicro.com)
- ruby Ruby
- scrapy Scrapy
- screaming frog seo spider Spider SEO Screaming Frog
- searchmetricsbot SearchmetricsBot
- semrushbot Bot d'analyse SEO
- seokicks SEOKicks
- seznambot SeznamBot
- shopwiki ShopWiki
- shortlinktranslate Raccourcisseur de liens
- showyoubot Spider de l'app Showyou iOS
- siege Joe Dog Siege
- sistrix SISTRIX
- siteuptime Services de surveillance de site
- slack Slackbot-LinkExpanding
- slackbot Bot Slack
- slurp Spider Yahoo
- smtbot SimilarTech
- socialrank SocialRankIOBot
- sogou Moteur de recherche chinois
- spbot OpenLinkProfiler
- spider Spider web générique
- spinn3r Agrégateur Spinn3r
- sputnikbot SputnikBot
- squider Squider
- statuscake StatusCake
- stripe Stripe
- test certificate info Bibliothèque http C ?
- tineye Bot TinEye
- traackr Bot Traackr
- trendictionbot Trendiction Search
- turnitinbot TurnitinBot
- tweetedtimes The Tweeted Times
- tweetmemebot Crawler TweetMeMe
- twikle Bot de recherche web social
- twitjobsearch TwitJobSearch
- twitmunin Twitmunin
- twitterbot Expanseur d'URL Twitter
- twurly Twurly
- typhoeus Typhoeus
- umbot uberMetrics
- unwindfetch Gnip
- uptimerobot Uptime Robot
- vagabondo Vagabondo
- vb project Visual Basic
- vigil Vigil
- vkshare Partageur VKontake
- voilabot VoilaBot
- vrcrawler Venture Radar
- wasalive-bot Wasalive Bots
- watchsumo WatchSumo
- wbsearchbot Ware Bay Best Buys
- webscout Webscout
- wesee WeSEE
- wget wget CLI unix client http
- wordpress Spider WordPress
- wormly WormlyBot
- wotbox Wotbox
- xenu link sleuth Xenu Link Sleuth
- xing-contenttabreceiver Bot Xing
- xovibot XoviBot
- yacybot YaCy
- yahoo-ad-monitoring Surveillance des annonces Yahoo
- yandex Yandex
- yeti Naver Corp
- yourls YOURLS
- zelist.ro Analyseur de flux
- zibb Spider ZIBB
- zitebot Zite
- zyborg Zyborg
Fournisseurs cloud identifiés comme des robots
De nombreux robots ne s'identifient pas comme tels, mais nous suivons les fournisseurs de services internet et identifions le trafic provenant des principaux fournisseurs cloud comme étant probablement des robots.
- Google Cloud
- Microsoft Corporation
- OVH SAS
- DigitalOcean
- Huawei Clouds
- Google-private-cloud
- Amazon.com
- Google Proxy
- Omonia d.o.o.
- ColoCrossing
FAQs sur les robots de recherche
Comment Linkly détecte-t-il les robots ?
Linkly identifie les robots via leur chaîne user agent (de nombreux robots s'annoncent) et en vérifiant si le trafic provient de fournisseurs d'hébergement cloud ou de centres de données connus.
Un robot manque-t-il de cette liste ?
Nous mettons régulièrement à jour notre détection des robots. Si vous voyez du trafic provenant d'un robot ne figurant pas dans cette liste, contactez-nous et nous l'ajouterons.
Pourquoi certains clics sont-ils marqués comme des robots alors qu'il s'agit d'utilisateurs réels ?
Les utilisateurs sur des VPN ou des réseaux d'entreprise peuvent être signalés comme des robots car leur trafic passe par des centres de données. Consultez notre article sur le trafic VPN pour plus d'informations.
Obtenez 100 liens courts et suivez 500 clics mensuels gratuitement.